Témoignage client
5 millions
d'agents IA s'exécutent chaque mois dans les flux de travail métier des clients
10 fois
plus rapide pour créer des agents de production
Des modèles de pointe, des outils d'orchestration, une gestion du contexte et une infrastructure conçus pour fonctionner ensemble.
Pour les charges de travail qui doivent s'exécuter aux États-Unis, l'inférence réservée aux États-Unis est disponible à un prix 1,1 fois supérieur pour les jetons en entrée et en sortie. En savoir plus.
Obtenez des vitesses jusqu'à 2,5 fois plus élevées avec le mode rapide pour Opus 5, pour 2 fois le prix standard. En savoir plus.
Le tarif de la mémorisation des requêtes tient compte d'un TTL de 5 minutes. En savoir plus sur la mémorisation étendue des requêtes.
Accédez aux modèles de pointe de Claude via l'API Messages pour développer avec un contrôle total et une personnalisation complète.
Exécution de code
Exécutez du code Python, créez des visualisations et analysez les données dans les appels API.
Résultats structurés
Assurez-vous que les réponses de Claude sont conformes à votre schéma JSON.
Utilisation des outils
Autorisez Claude à interagir avec des centaines d'outils et API externes afin qu'il puisse effectuer un plus grand nombre de tâches.
Utilisation de l'ordinateur
Laissez Claude voir et utiliser un navigateur ou un bureau pour automatiser le travail dans des applications qui n'ont pas d'API.
Références
Ancrez les réponses dans les documents sources.
Fichiers
Téléchargez et référencez des documents à travers les conversations.
Fenêtre de contexte
Exécutez des cas d'usage plus complets et à forte intensité de données avec jusqu'à 1 million de jetons de contexte.
Compactage
Résumez automatiquement le contexte plus ancien lorsque vous approchez des limites de jetons.
Modification du contexte
Effacez automatiquement les appels d'outils et les résultats.
Recherche et récupération sur le Web
Importez les données actuelles du Web dans Claude.
d'agents IA s'exécutent chaque mois dans les flux de travail métier des clients
plus rapide pour créer des agents de production
Créez et déployez à grande échelle des agents fonctionnant en continu.
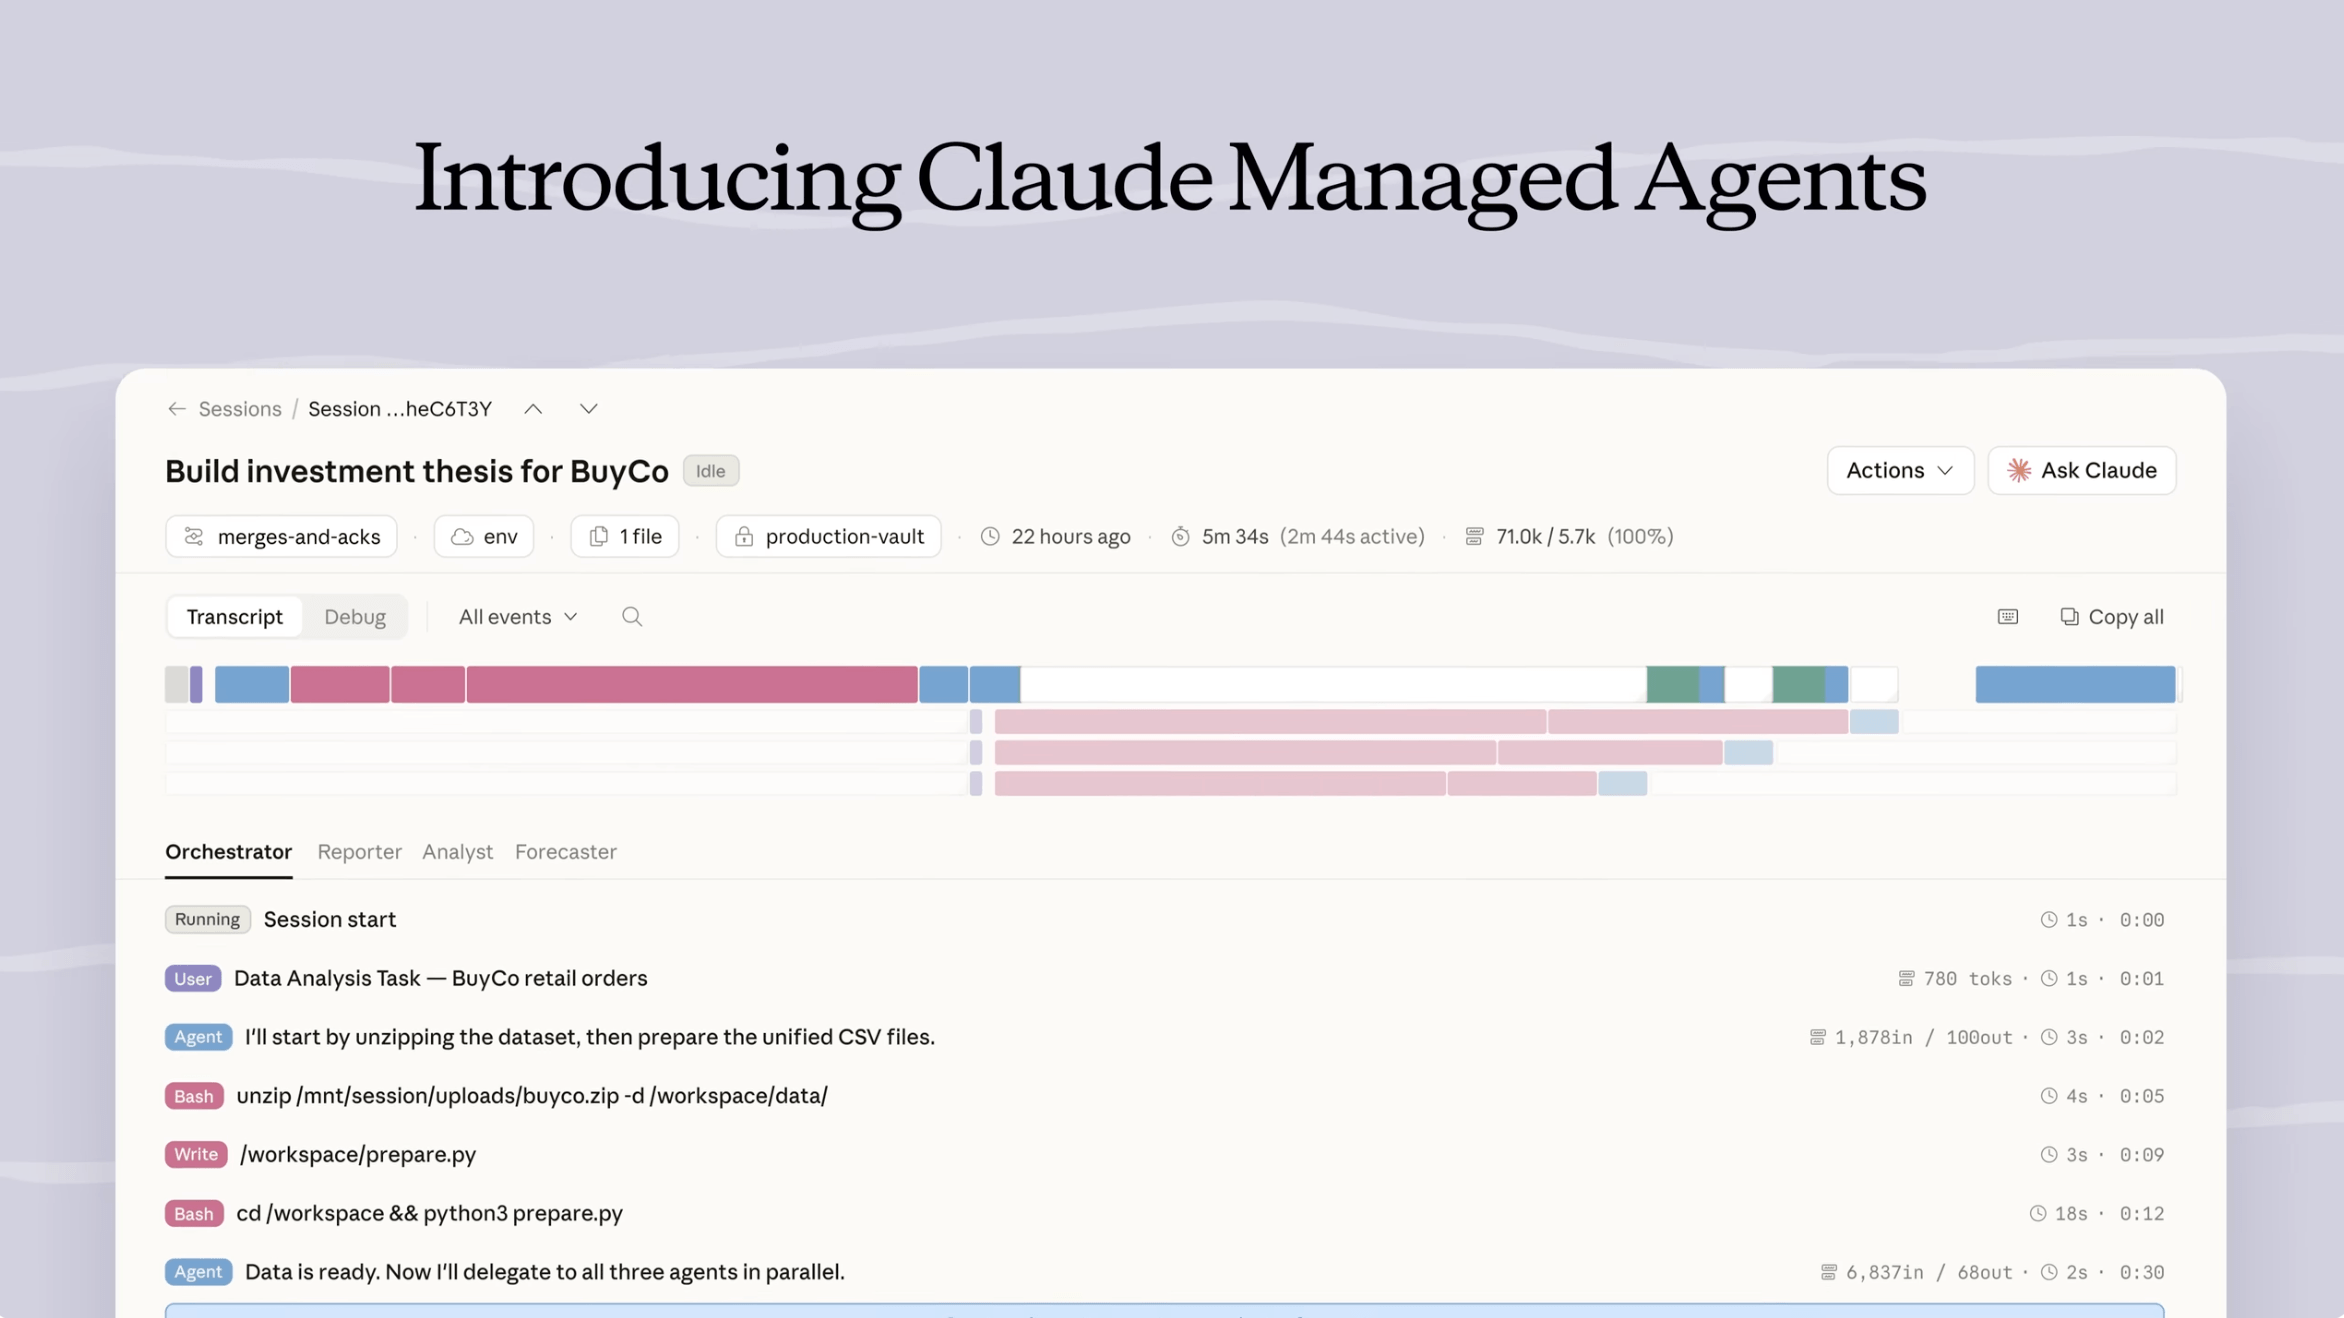
Les identifiants restent en dehors de la sandbox, le chiffrement est intégré et l'état persiste automatiquement.
Le traçage de session enregistre ce que chaque agent a fait et pourquoi, avec des analyses intégrées pour améliorer les performances des agents.
L'infrastructure sous-jacente est optimisée pour Claude. À mesure que le modèle s'améliore, vos agents s'améliorent avec lui.
Étendez et personnalisez ce que Claude peut faire.
Connectez Claude à vos outils et à vos données via la norme ouverte pour les intégrations IA.
Transmettez à Claude votre expertise, vos procédures et vos bonnes pratiques grâce à des skills prédéfinies ou personnalisables.
Les agents mémorisent les informations d'une session à l'autre et gardent des fichiers de mémoire sur votre infrastructure.
Utilisez votre engagement Anthropic existant pour financer les solutions alimentées par Claude proposées par nos partenaires.
Contrôles et mesures de protection de vos données.
Offre aux clients éligibles la confidentialité d'une rétention zéro des données (ZDR) ainsi que des mesures de pointe pour détecter les utilisations abusives.
Sur votre fournisseur de cloud, choisissez l'endroit où vos données sont stockées et où les requêtes sont traitées, avec des régions en Asie-Pacifique, au Canada, en Europe et aux États-Unis.
Par défaut, Anthropic n'utilise pas les données clients issues des déploiements commerciaux pour entraîner Claude.
Créez directement sur Claude Platform, avec la sécurité et le support d'entreprise intégrés. Ou utilisez Claude dans le cloud que vous utilisez déjà, notamment Amazon Web Services, Google Cloud ou Microsoft Foundry.
Traitez de grands volumes de requêtes de manière asynchrone et économisez 50 % sur les coûts.
Donnez à Claude des connaissances contextuelles et des exemples pour réduire les coûts jusqu'à 90 %.
Choisissez l'intensité du travail de Claude sur une tâche.
Des modèles plus rapides et abordables font appel à des modèles plus intelligents pour évaluer les plans ou le travail afin d'améliorer les performances.
Pour Quora, le traitement par lots permet de réaliser des économies tout en réduisant la complexité liée à l'exécution d'un grand nombre de requêtes qui n'ont pas besoin d'être traitées en temps réel.
Votre centre de commande, avec analyses et contrôles intégrés.
Vous êtes un assistant IA spécialisé dans le classement des tickets d'assistance client. Votre tâche consiste à analyser le contenu d'un ticket et à le classer dans la catégorie la plus pertinente à partir d'une liste prédéfinie. Vous devez également fournir le motif de votre décision.
Tout d'abord, examinons les catégories disponibles :
<category_list>
{{CATEGORY_LIST}}
</category_list>
Voici le contenu du ticket d'assistance à classer :
<ticket_content>
{{TICKET_CONTENT}}
</ticket_content>
Veuillez suivre ces étapes pour accomplir la tâche :
– Lisez attentivement le contenu du ticket et analysez-le.
– Évaluez la correspondance entre ce contenu et les différentes catégories disponibles.
– Choisissez la catégorie la plus pertinente pour ce ticket.
– Fournissez une explication détaillée de votre raisonnement.
Utilisez la structure suivante pour votre réponse :
<classification_analysis>
Dans cette section, détaillez votre processus de réflexion :
– Citez les parties les plus pertinentes du contenu du ticket.
– Répertoriez chaque catégorie et notez son lien avec le contenu du ticket.
– Pour chaque catégorie, fournissez des arguments pour et contre la classification du ticket dans cette catégorie.
– Classez les 3 catégories les plus probables.
</classification_analysis>
<classification>
<category>Indiquez ici la catégorie sélectionnée</category>
<reasoning>Résumé du raisonnement qui a conduit au choix de cette catégorie</reasoning>
</classification>
Veillez à faire preuve de rigueur dans votre analyse et de clarté dans vos explications. Votre objectif est de fournir un classement précis accompagné d'un raisonnement bien étayé.
Créez des requêtes de prototype, importez des skills et des fichiers, configurez vos agents.
Exécutez des agents sur des environnements hébergés dotés de coffres-forts et de mémoire.
Suivez l'utilisation, les coûts, la mise en cache et les limites de débit par modèle et par clé API.
Contrôlez les clés API, les membres, les limites de jetons et la sécurité par espace de travail.
“Developers want agents that can take on real software work and finish it. In our testing across GitHub Copilot CLI and VS Code, Claude Opus 5.5 used among the fewest tokens and steps we measured. In VS Code, it solved more terminal tasks than Opus 5 in less than half the steps. More than making individual tasks more efficient, it’s making developers’ bigger projects more achievable.”
“Developers want agents that can take on real software work and finish it. In our testing across GitHub Copilot CLI and VS Code, Claude Opus 5.5 used among the fewest tokens and steps we measured. In VS Code, it solved more terminal tasks than Opus 5 in less than half the steps. More than making individual tasks more efficient, it’s making developers’ bigger projects more achievable.”
“For Lovable builders, Opus 5.5 means faster builds with the same quality, whether you’re starting from scratch or working on a live app. It gathers context once, makes fewer and more complete edits, and doesn’t get stuck retrying, finishing in a third to half fewer steps and using significantly fewer tokens along the way.”
“For Lovable builders, Opus 5.5 means faster builds with the same quality, whether you’re starting from scratch or working on a live app. It gathers context once, makes fewer and more complete edits, and doesn’t get stuck retrying, finishing in a third to half fewer steps and using significantly fewer tokens along the way.”
“With Claude Opus 5.5, we’ve seen a clear improvement in token efficiency across our internal evaluations, as we’ve been able to complete the same tasks both cheaper and faster.”
“With Claude Opus 5.5, we’ve seen a clear improvement in token efficiency across our internal evaluations, as we’ve been able to complete the same tasks both cheaper and faster.”
“Financial firms need outputs that are consistently correct. At its lowest effort setting, Claude Opus 5.5 beat Opus 5 at high effort on our BigFinance Bench with about 60% fewer output tokens. Its answers are shorter and better structured, and its slides come out denser, more in line with industry standards.”
“Financial firms need outputs that are consistently correct. At its lowest effort setting, Claude Opus 5.5 beat Opus 5 at high effort on our BigFinance Bench with about 60% fewer output tokens. Its answers are shorter and better structured, and its slides come out denser, more in line with industry standards.”
“Claude Opus 5.5 is the first model we’d default to at medium effort. In our testing it matched Opus 5 on high effort, while using 20 to 25% fewer output tokens. On long, messy investigations it always came back with a clear, actionable answer. This means our customers get more done for less.”
“Claude Opus 5.5 is the first model we’d default to at medium effort. In our testing it matched Opus 5 on high effort, while using 20 to 25% fewer output tokens. On long, messy investigations it always came back with a clear, actionable answer. This means our customers get more done for less.”
“Our customers use Box AI on enormous amounts of content, so speed and cost are a top priority. In our evaluations, Claude Opus 5.5 used a third of the tokens Opus 5 did, and its answers were 40% less verbose without losing accuracy. We expect that to matter a lot for teams running agents across their content in areas like financial services and the public sector.”
“Our customers use Box AI on enormous amounts of content, so speed and cost are a top priority. In our evaluations, Claude Opus 5.5 used a third of the tokens Opus 5 did, and its answers were 40% less verbose without losing accuracy. We expect that to matter a lot for teams running agents across their content in areas like financial services and the public sector.”
« Claude Fable 5.1 est l'un des meilleurs modèles pour nos évaluations d'investigation d'incidents, qui s'appuient sur de véritables incidents de production pour mesurer l'efficacité de notre agent, Bits Investigation, à produire des analyses de cause racine. Nous comparons les résultats de notre agent aux causes racines identifiées par nos ingénieurs. Lors de ces évaluations, il a fait preuve d'un raisonnement plus solide qu'Opus 5 et a diagnostiqué avec succès les incidents de production les plus complexes que nous ayons testés. »
“Claude Fable 5.1 is a leading model for our incident investigation evals, which use real production incidents to assess how effectively our agent, Bits Investigation, can produce root cause analyses. We evaluate our agent's output against root causes identified by our engineers. In these evaluations, it has demonstrated stronger reasoning than Opus 5 and has successfully diagnosed the most complex production incidents we've tested.”
« Nous basculons notre trafic Opus 5 dans Devin vers Claude Fable 5.1 dès le jour du lancement. Lors de nos tests, il a égalé, voire légèrement dépassé Fable 5 pour un coût par tâche inférieur, et avec la nouvelle tarification des lectures en cache, un modèle de la classe Fable devient enfin rentable pour les charges de travail que nous avions conservées sur Opus, à commencer par la revue de code. »
“We're moving our Opus 5 traffic in Devin to Claude Fable 5.1 on launch day. It matched or edged out Fable 5 in our testing at a lower cost per task, and with the new cache read pricing a Fable-class model is finally economical for the workloads we'd kept on Opus, starting with code review.”
« Nous avons demandé à Claude Fable 5.1 d'examiner un projet de recherche clinique pour Rakuten Medical que trois autres modèles de pointe avaient validé. Il a repéré une lacune qu'aucun d'eux n'avait vue et a insisté pour l'approfondir. Il a ensuite proposé une hypothèse entièrement nouvelle, transformant en un après-midi un jeu de données que nous avions abandonné en une nouvelle piste de recherche. C'est la première fois qu'un modèle de pointe comme Claude nous permet d'explorer de nouvelles recherches de cette manière. »
“We asked Claude Fable 5.1 to review a clinical research project for Rakuten Medical that three other frontier models had signed off on. It found a gap none of them had seen and insisted on testing it further. It then proposed a completely new hypothesis, turning a dataset we had written off into a new research direction in one afternoon. It's the first time a frontier model like Claude has empowered us to explore new research in this way.”
« Ce qui distingue Claude Fable 5.1, c'est la rédaction : plus compréhensible, plus pertinente, et le modèle respecte mieux nos consignes rédactionnelles. Lors de tests à l'aveugle face à Fable 5, j'ai préféré ses textes et ses résultats. Et dans Canva Code, il a créé un jeu de rythme avec de la vraie musique et un gameplay calé sur le tempo, adapté au niveau qu'il avait lui-même généré, ce qu'aucun autre modèle testé n'a su faire. »
“The standout in Claude Fable 5.1 is the writing: more understandable, more meaningful, and it follows our writing guidance better. In blind tests against Fable 5, I preferred its writing and output. And in Canva Code it built a rhythm game with real music and on-beat gameplay matched to the level it generated, something no other model we tested delivered.”
« Sur notre suite de recherche, Claude Fable 5.1 a établi de nouveaux records. Sur une tâche, il a imaginé une solution inédite selon un axe totalement différent de ce que nous avions vu chez d'autres modèles ou chez des chercheurs humains par le passé, ce qui a porté ses résultats bien au-delà du plateau précédent. Il est meilleur pour la résolution créative de problèmes et pour trouver l'éclair de compréhension nécessaire face à une question difficile. »
“On our research suite, Claude Fable 5.1 set new best scores. On one task it came up with a novel solution along a completely different axis than we'd seen from other models or from human researchers in the past, which took its results well above the previous plateau. It's better at creative problem solving and getting that flash of insight you need to solve a difficult problem.”
« La décision de choisir Claude s'est entièrement fondée sur les données. Nous avons testé plusieurs fournisseurs de modèles côte à côte, et Claude a toujours obtenu les meilleurs résultats en termes de taux de résolution de cas et de taux de satisfaction client. »
“The decision to choose Claude was entirely data-driven. We tested multiple model providers side by side, and Claude consistently delivered the best results for case resolution rates and customer satisfaction scores.”
« Le partenariat avec Anthropic a été exceptionnel : les conseils et le soutien de leurs équipes ont aidé nos ingénieurs à tirer le meilleur parti des modèles. »
“The partnership with Anthropic has been exceptional—their guidance and support have helped our engineering teams maximize the models.”
Recevez la newsletter des développeurs
Mises à jour de produits, procédures, membres de la communauté à l’honneur, et plus encore. Envoyée mensuellement dans votre boîte de réception.